Видео с ютуба Rlaif Analysis

Обучение с подкреплением для рассуждений LLM. RL / RLHF / RLAIF.

#323 RLAIF-V: ИИ-фидбек с открытым исходным кодом для мультимодальных языковых моделей
Обучение с подкреплением с обратной связью от ИИ (RLAIF) | Конституционный ИИ
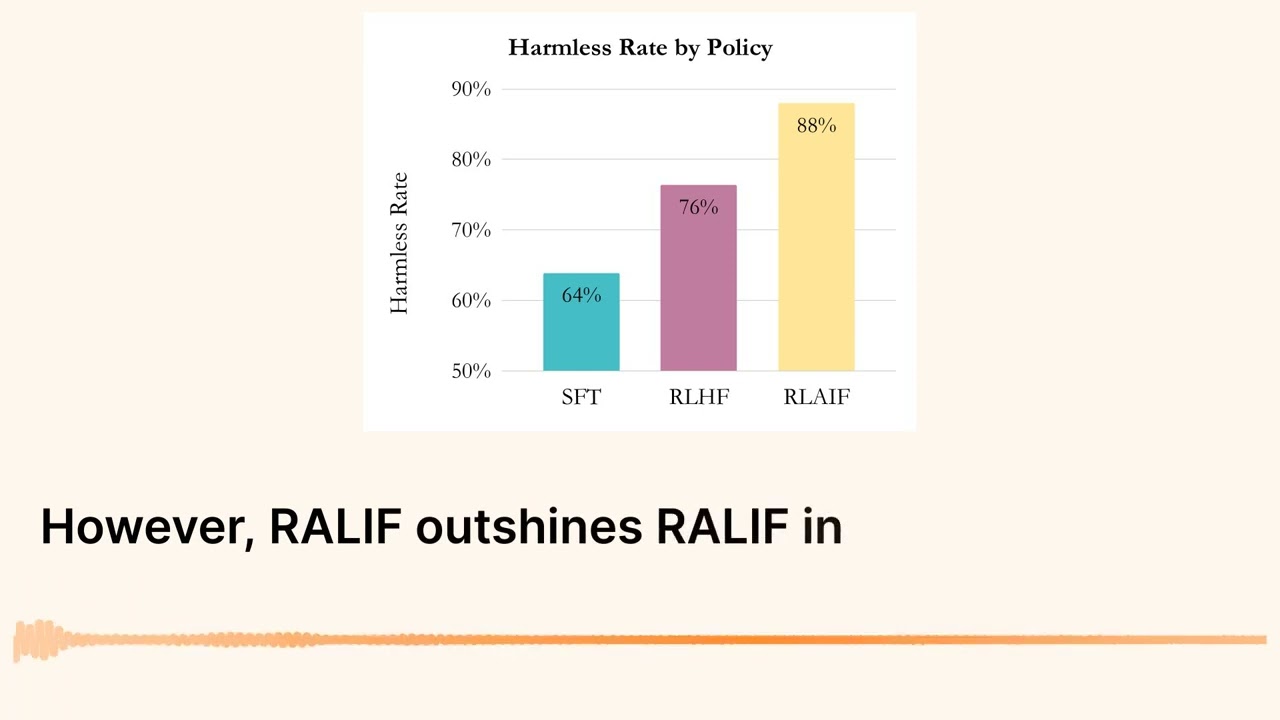
AI Feedback vs Human Feedback: Revolutionizing Reinforcement Learning RLAIF
Reinforcement Learning from Human Feedback (RLHF) Explained

Reinforcement Learning with Human Feedback (RLHF), Clearly Explained!!!
RLAIF vs. RLHF: the technology behind Anthropic’s Claude (Constitutional AI Explained)
Обучение с подкреплением на основе отзывов людей: простыми словами (и RLAIF)
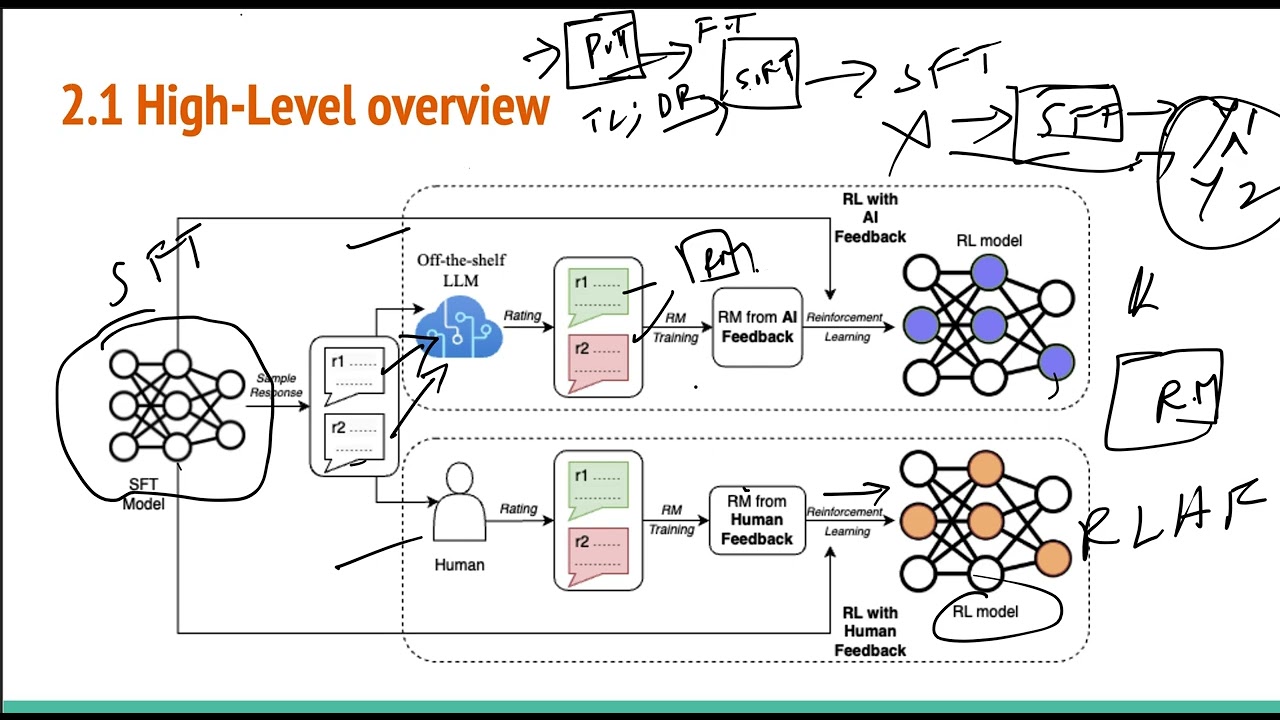
RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback
Reinforcement Learning with AI Feedback (RLAIF) for Large Language Models

RLAIF: как выглядит создание настоящего ИИ-агента — Фаза 0 ЗАВЕРШЕНА!

RLAIF Railtown: результаты за 3-й квартал опубликованы. Что изменилось на самом деле.

How RLAIF Improves AI Training Without Human Labels

Reinforcement Learning with Human Feedback (RLHF) in 4 minutes

Generative Reward Models: Merging the Power of RLHF and RLAIF for Smarter AI
Constitutional AI: Training a Harmless LLM from AI Feedback (RLAIF)

4 Ways to Align LLMs: RLHF, DPO, KTO, and ORPO